빅밸류 “AI 레디 데이터, 현실과의 격차 줄여야 한다”
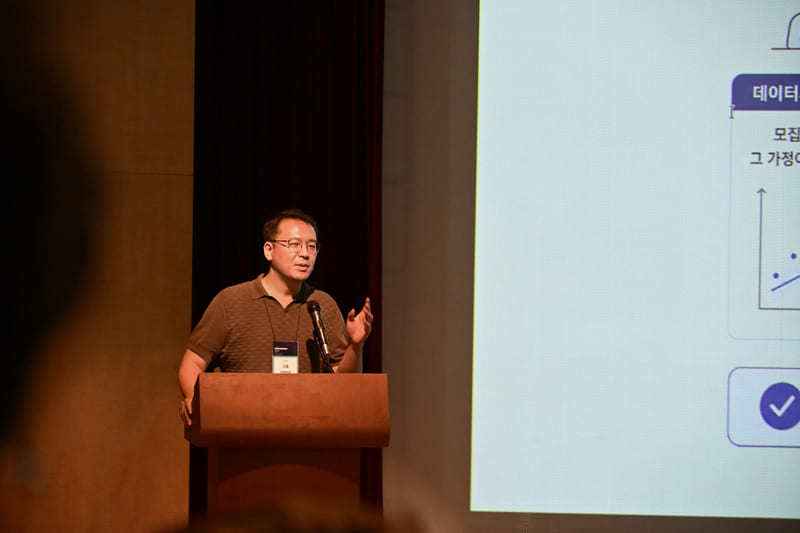
데이터테크 기업 빅밸류의 구름 대표가 지난 3일 서울 포스코타워 역삼 이벤트홀에서 열린 ‘AI Ready Data 2026’에 연사로 참여해 ‘현장에서 본 AI 레디 데이터의 조건’을 주제로 발표했다고 8일 밝혔다.
중앙대학교 문헌정보학과 HIKE 연구실이 주최·주관한 이번 세미나는 ‘AI가 조직에서 동작하려면, 데이터는 무엇을 갖춰야 하는가’를 주제로 열렸다. 공공 AX와 기업 데이터 전략, 온톨로지와 지식그래프, AI 에이전트, AI 레디 데이터 표준과 구축 등 조직의 AI 활용을 뒷받침하는 데이터 과제를 산업계와 학계의 시각에서 다뤘다.
구 대표는 AI 활용이 활성화 되려면 먼저 신뢰 조건을 설계해야 한다고 설명했다. AI 학습에 앞서 조직이 현실과 데이터 사이의 차이를 파악하고 AI가 맡을 업무에 필요한 수준까지 데이터를 준비하는 과정이 필요하다는 것이다.
이어 현장에서 AI 도입을 가로막는 요인으로 실무 전문가, 축적된 데이터, AI·데이터 전문가 사이의 세 가지 괴리를 제시했다. 첫째는 조직이 필요한 데이터를 이미 보유하고 있다고 믿는 ‘보유의 착각’이다. 구 대표는 전국 단위 현장조사 데이터가 입력 오류와 조사자별 편차로 활용되지 못한 사례, 농지 데이터의 갱신 지연을 위성영상 분석으로 보완한 조류인플루엔자 위험도 예측 사례, 자사 매출만으로 설명하지 못한 점포 매출을 외부 카드 매출과 경쟁 환경 데이터로 보강한 사례를 소개했다.
둘째는 현업의 경험과 AI·데이터 전문가의 분석 사이에서 생기는 ‘경험의 착각’이다. 오랜 기간 축적된 현장 판단을 곧바로 배제하기보다 조건과 범위를 데이터로 확인하고, 전문가의 경험을 측정 가능한 변수로 바꾸는 과정이 필요하다는 설명이다. 학습 데이터가 많더라도 실제 판단 시점의 데이터가 늦게 들어오면 결과가 흔들리는 만큼, 적시성은 단순한 데이터 정제 문제가 아니라 장기간 투자해야 하는 공급 인프라의 문제라고도 짚었다.
셋째는 데이터가 모여 있어도 실제 업무에는 쓰기 어려운 ‘가용의 착각’이다. 단일 표의 형식 오류만 점검해서는 발견하기 어려운 문제를 찾으려면 서로 다른 데이터의 개체와 기준을 연결해야 한다. 구 대표는 같은 필지를 다루는 여러 공적 장부의 면적 값이 다르거나, 주소 데이터가 실제 상권과 맞지 않았던 사례를 들어 연결된 데이터가 오류를 드러내고 신뢰할 기준을 정하는 출발점이라고 설명했다.
데이터 표준을 AI 레디 데이터의 완성 상태로 보는 시각도 경계했다. 표준은 데이터를 연결하고 다양한 방식으로 실험하기 위한 출발선이며, 실제 업무에서 신뢰할 수 있는 결과를 얻으려면 실무자와 AI·데이터 전문가가 서로의 한계를 이해하고 현장 검증과 피드백을 반복해야 한다고 강조했다.
빅밸류는 이러한 현장 경험을 바탕으로 기업의 데이터 현황과 AI 활용 가능성을 진단하고, AI 도입 목적에 맞는 데이터 확보·연결·품질 검증 및 운영 체계를 설계하는 AI 레디 데이터 컨설팅을 본격화한다는 방침이다.
◈ AI 해커가 움직인다, 지금 보안팀이 알아야 할 것(온라인)
일시 : 2026년 9월 15일 (화) 14:00 ~ 15:00
장소 : 온라인 웨비나
◈ 금융 테크 컨퍼런스 2026 – AI × Security × Finance
일시 : 9월 22일 (화) 09:00 ~ 17:30
장소 : 서울 영등포구 여의도동 여의대로 24 FKI타워 컨퍼런스센터 1층 그랜드볼룸
글. 바이라인네트워크
<오민선 기자>omsoms94@byline.network
함께 보면 좋은 자료