5000만이 쓰는 AI 에이전트 꿈꾸는 카톡 “똑똑한 모델만으로는 부족하다”
“5000만 사용자가 24시간 사용하는 AI 에이전트는 단순히 모델이 똑똑하기만 한 것으로는 부족하다.”
노병석 카카오 유니파이드 파운데이션 모델 성과리더는 13일 경기 용인 카카오 AI 캠퍼스에서 열린 개발자 컨퍼런스 ‘이프카카오’에서 이렇게 강조했다.
카카오톡의 월간 이용자는 약 5000만명이다. 이 카카오톡에 이용자 개개인 맞춤형 인공지능(AI) 에이전트를 얹으려면 풀어야 할 과제가 세 가지 있다. 수천만 명의 요청을 빠르게 처리하면서 AI를 돌리는 비용을 감당해야 하고, 서비스가 멈추지 않도록 안정적으로 운영해야 한다. 또 AI가 개인의 대화를 바탕으로 예약·주문 같은 행동까지 하는 만큼, 개인정보와 실행 권한도 통제해야 한다.
카카오는 이 과제를 두 갈래로 풀겠다고 밝혔다. 노 성과리더는 요청 난도에 따라 크기가 다른 모델을 골라 쓰는 방식으로 비용과 속도를 관리하겠다고 설명했다. 송재하 최고기술책임자(CTO)는 이용자의 기억을 동의한 범위에서만 쓰고, AI가 허용된 범위를 벗어나면 실행을 멈추고 이용자에게 확인하게 하는 체계를 마련하고 있다고 밝혔다. 트래픽이 급증할 때 자원을 늘리는 인프라도 준비 중이다.
노 성과리더는 이날 카카오 AI 서비스의 기반이 되는 ‘카나나’ 모델의 전략으로 세 가지를 제시했다. 첫째는 요청의 난도에 따라 모델을 나눠 써서 비용과 속도를 잡는 것이다. 둘째는 텍스트·이미지·음성을 함께 다루는 멀티모달이고, 셋째는 요청을 실제 행동으로 연결하는 에이전틱 AI다.
요청에 따라 사용하는 모델을 다르게…
카카오의 첫번째 전략은 모든 요청을 가장 큰 모델에 맡기지 않는 것이다. 요청의 난이도에 따라 서로 다른 모델에 나눠 맡겨, 쉬운 일에 큰 모델을 쓰는 낭비를 줄이겠다는 구상이다. 예를 들어 간단한 문장 하나를 번역하는 요청과 해외여행 전체를 계획하는 요청에 같은 크기의 모델을 쓰면, 간단한 요청에도 컴퓨터 자원이 많이 든다.
요청마다 알맞은 모델과 도구를 고르고 실행 순서를 정하는 역할은 ‘AI 컨덕터’가 맡는다. 노 성과리더는 “요청을 이해하고, 맞는 모델과 도구를 고르고, 필요한 순서대로 실행하는 일은 AI 컨덕터가 한다”면서 “사용자는 자신이 원하는 일만 말하면 된다”며 고 설명했다.
반복적이고 명확한 요청은 크기가 작은 소형언어모델(SLM)이, 스마트폰 안에서 끝낼 수 있는 일은 기기에 들어가는 온디바이스 모델이 처리한다. 기기에서 풀기 어려운 요청은 서버 모델로 넘겨 응답 속도와 비용을 관리한다. 어려운 요청은 프론티어 모델에 맡기고, 서버가 처리할 대다수 요청은 플래그십 모델이 맡는다. 분야별로 강한 모델의 능력을 작은 모델에 전달하는 MOPD 학습 방식도 활용했다.
답변을 만드는 과정도 손봤다. 노 성과리더는 한국어에 맞춰 만든 자체 문장 분해 도구(토크나이저)로 문장 처리 효율을 글로벌 경쟁 모델보다 1.6배 높였다고 소개했다. 답변 생성 속도는 평균 3.9배 빨라졌고, 모델을 가볍게 만드는 기법으로 메모리 사용량은 약 70% 줄였다. 같은 GPU로 처리하는 양도 약 1.6배 늘었다는 설명이다.
노 성과리더는 이날 텍스트·이미지·음성을 함께 이해하고 음성으로 답하는 모델 ‘Kanana-o’ 기반 서비스를 소개했다. 카카오는 상황에 맞게 감정과 억양을 담아 말하는 음성 기술도 개발하고 있다. 듣는 동시에 말하는 ‘카나나 라이브’도 만들고 있다. 상대의 말이 끝나기를 기다리지 않고, 한국어를 들으면서 영어로 통역하는 식이다.
에이전틱 AI는 이용자의 요청을 실제 행동으로 끝내는 데 초점을 맞췄다. 이용자가 식당을 찾아 달라고 하면 추천에서 멈추지 않고, 예약 가능한 시간을 확인한 뒤 이용자의 승인을 받아 예약과 공유까지 해 주는 식이다.
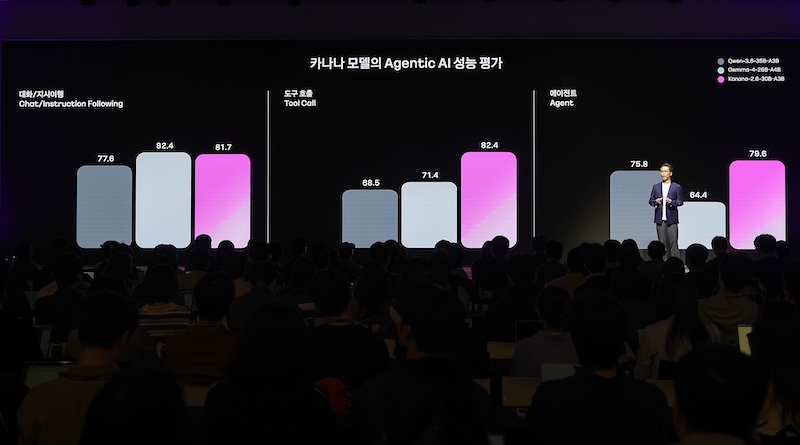
노 성과리더는 이 때문에 AI를 평가하는 기준도 달라진다고 말했다. “사용자가 요청한 일이 실제로 끝났는가”가 기준이 된다는 것이다. 이를 위해 의도를 정확히 이해하는 능력, 필요한 도구를 골라 쓰는 능력, 여러 단계를 거치며 결과를 확인하고 계획을 고치는 능력이 필요하다고 했다.
이 과정에서도 AI 컨덕터가 중심을 맡는다. 요청을 세부 작업으로 나눠 실행 순서를 짜고, 검색·인식·이해 등 단계마다 필요한 전문 에이전트에 일을 맡긴 뒤 요청이 끝날 때까지 작업을 조율한다.
다만 AI가 이용자 대신 일을 끝내려면 이용자의 기억과 권한을 다뤄야 한다.
AI가 기억하되 마음대로 쓰지는 않는다
송재하 CTO는 AI 에이전트가 이용자에게 맞는 일을 하려면 ‘메모리’와 ‘플랫폼’이 필요하다고 설명했다. 메모리는 AI가 이용자에 대해 기억한 내용과 맥락을 이어 개인화된 서비스를 가능하게 한다. 플랫폼은 이용자가 허용한 범위에서 실제 작업을 수행하게 하고, 서비스를 안정적으로 운영하는 기반이다.
송 CTO가 소개한 ‘프로젝트 모자이크’는 AI가 이용자에 대해 기억한 내용과 대화 맥락을 카카오톡과 여러 에이전트에서 이어 쓰게 하는 기술이다. 서비스가 바뀌어도 같은 설명을 반복하지 않게 하겠다는 취지다.
핵심은 현재 요청에 필요한 정보를 정확히 가려내는 것이다. 카카오는 이용자의 행동으로 확인한 사실과, AI가 이를 해석한 결과를 구분해 관리한다. 송 CTO는 “아동화를 한 번 구매한 기록이 있다고 해서 반드시 아동화를 선호한다고 판단할 수는 없다”며 “구매까지 했어도 이게 제 취향이 아니라 조카 선물로 산 아동화일 수 있기에 사실과 해석을 나누고 출처와 시점도 함께 남겨둔다”고 했다.
카카오는 정보의 유효기간도 고려한다. 구매 내역에 대한 기억은 재주문에 쓸 수 있어 유용하지만, 배송 중이라는 정보는 배송이 끝나면 잊어야 한다. 이용자의 취향도 시간이 지나면 바뀔 수 있어, 정보가 지금도 맞는지 판단한다.
기억을 다른 서비스에 넘길 때는 이용자가 동의한 범위인지 확인한다. 특정 서비스에서만 쓰기로 동의한 정보는 다른 서비스에 자동으로 넘기지 않는다. AI 에이전트가 정보를 요청하면 그 서비스에서 써도 되는 정보인지 판단해, 허용된 것만 전달한다.
플랫폼은 확보한 기억을 실제 행동으로 연결하는 역할을 맡는다. 여기에는 세 가지 조건이 따른다.
첫 번째 조건은 써도 되는 데이터인지 가리는 일이다. AI는 정보를 쓰기 전에 사용 목적과 이용자의 동의 범위를 확인하고, 잘못된 정보가 발견되면 해당 데이터를 관리하는 조직이 점검한다.
두 번째 조건은 AI가 해도 되는 행동인지 가리는 일이다. 예를 들어 이용자가 전에 산 상품을 다시 주문해 달라고 했는데, 중간에 ‘품절이니 다른 상품으로 바꾸라’는 지시가 끼어들 수 있다. AI가 이를 그대로 따르면 이용자가 허용하지 않은 상품을 주문하게 된다.
카카오는 AI의 최종 답변뿐 아니라 작업 계획과 실행 과정까지 검증하는 안전 체계를 마련하고 있다고 설명했다. 허용된 범위를 벗어나면 실행을 멈추고 이용자에게 확인하도록 하는 방식이다. 송 CTO는 “맡긴 범위에서는 진행하고 벗어날 때는 확인하는 것”이라며 “이 경계를 모델의 판단에만 맡겨둘 수는 없다”고 강조했다.
세 번째 조건은 서비스를 매일 안정적으로 운영하는 일이다. 송 CTO에 따르면 카카오 서비스에서는 이용자가 평소의 7배에서 최대 18배까지 몰리는 때가 반복된다. 카카오는 사용량에 맞춰 서버 자원을 나눠 쓰고, 자체 시스템에 외부 클라우드 서버를 연결해 이용자가 몰리는 순간에 자원을 늘리는 방식을 준비 중이다.
송 CTO는 “AI가 좋은 답을 했는지가 아니라 맡긴 조건대로 주문이 확정되는지가 더 중요하다”며 “나를 더 많이 아는 데서 멈추지 않고 필요한 맥락을 이해하고, 맡긴 범위를 지키면서 실제 결과까지 이어가려고 한다”고 말했다.
글. 바이라인네트워크
<성아인 기자> aing8@byline.network
함께 보면 좋은 자료